EmbeddingGemma 2 : Le nouveau modèle multimodal ultra-léger de Google pour le RAG local
Qu'est-ce qu'EmbeddingGemma 2 ?
EmbeddingGemma 2 est un modèle d'IA d'embedding (vectorisation) multimodal de 0,74 milliard de paramètres (0.74B) développé par Google. Publié sous licence open source Apache 2.0, il est disponible au téléchargement gratuit sur Hugging Face et Kaggle. Ce modèle est conçu spécifiquement pour exécuter des tâches de recherche sémantique et de RAG local (Retrieval-Augmented Generation) directement sur l'appareil de l'utilisateur (smartphones, PC, serveurs locaux) sans nécessiter de connexion internet ni envoyer de données vers des serveurs tiers.
Contrairement aux modèles de génération de texte traditionnels, EmbeddingGemma 2 ne génère pas de réponses textuelles : il convertit différents types de média — textes, fragments de code, images, enregistrements audio et vidéos — en vecteurs d'empreintes numériques au sein d'un espace vectoriel partagé.
Une architecture modulaire et multimodale unique
Jusqu'à présent, la plupart des pipelines de RAG nécessitaient des modèles d'embedding distincts pour chaque type de contenu (un modèle pour le texte, un autre pour la vision, un troisième pour l'audio). EmbeddingGemma 2 regroupe ces cinq modalités sous un étalon de mesure unique.
Une structure personnalisable par blocs
Le modèle global comporte 0,74B de paramètres, mais il s'appuie sur une conception modulaire permettant d'économiser les ressources de la mémoire RAM :
- Noyau Texte et Code : 0,27 milliard de paramètres (0.27B).
- Module Vision (Images / Vidéos) : 0,17 milliard de paramètres (0.17B).
- Module Audio : 0,30 milliard de paramètres (0.30B).
Cette modularité permet de n'charger que le module texte si l'application ne traite que du document écrit, réduisant l'empreinte mémoire au minimum.
Réduction de la taille vectorielle via MRL
Grâce à la technique Matryoshka Representation Learning (MRL), EmbeddingGemma 2 permet de réduire la dimension des vecteurs générés de 768 dimensions à 128 dimensions sans perte critique de précision. Cela permet de compresser la taille de la base de données vectorielle locale jusqu'à 6 fois.
Performances et Benchmarks
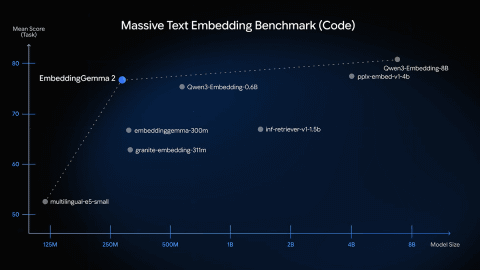
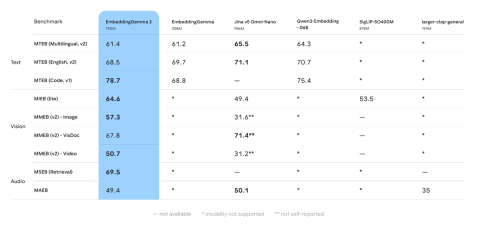
EmbeddingGemma 2 se positionne comme le leader des performances dans sa catégorie de taille pour le code et le multimédia, surpassant d'autres modèles ouverts de taille équivalente ou supérieure.
Tableau comparatif des performances de référence
| Domaine de test | Benchmark | EmbeddingGemma 2 (0.74B) | jina-embeddings-v5-omni-nano | EmbeddingGemma v1 | | :--- | :--- | :--- | :--- | :--- | | Code | MTEB Code | 78.68 | Non communiqué | 68.76 | | Image / Vidéo | MIEB (lite) | 64.60 | 49.40 | N/A | | Texte Multilingue | MTEB (Multilingual v2) | 61.40 | 65.50 | N/A | | Audio | MAEB | 49.40 | 50.10 | N/A |
Sur les tâches de recherche de code et d'analyse d'images/vidéos, EmbeddingGemma 2 surpasse nettement ses concurrents. Il accuse un léger retard sur le texte pur multilingue et l'audio par rapport à des modèles spécialisés comme jina-embeddings-v5-omni-nano, mais offre la meilleure polyvalence globale.
Empreinte mémoire et exécution On-Device
L'un des avantages majeurs d'EmbeddingGemma 2 réside dans sa légèreté lorsqu'il est quantifié pour tourner sur des processeurs mobiles ou embarqués.
- Sur Google Pixel 11 Pro (quantifié) :
- Configuration Texte uniquement (0.27B) : ~191 Mo de RAM
- Configuration Multimodale complète (0.74B) : ~567 Mo de RAM
- Fenêtre de contexte : 8K tokens par requête, capable d'analyser en une seule fois jusqu'à 5,5 minutes d'audio, 29 images ou 58 images clés de vidéo (frames).
- Frameworks compatibles : LiteRT et MediaPipe (Google AI Edge),
transformers,llama.cpp,Ollama,MLXetvLLM.
Associé à un modèle de langage local comme Gemma 4, EmbeddingGemma 2 permet de créer un système RAG 100 % privé : EmbeddingGemma 2 extrait l'information pertinente dans vos dossiers ou enregistrements vocaux, et Gemma 4 formule la réponse rédigée.
Foire aux questions (FAQ)
Quelle est la différence entre EmbeddingGemma 2 et les modèles Gemini ou Grok ?
EmbeddingGemma 2 est un modèle d'embedding open-weights ultra-léger de Google destiné à la recherche vectorielle locale. En comparaison, des modèles comme Gemini (Google) ou Grok (développé par xAI) sont des modèles de langage de grande taille (LLM) conversationnels fonctionnant principalement via des API Cloud infrastructure-intensive.
Est-il possible d'utiliser EmbeddingGemma 2 à des fins commerciales ?
Oui. Google a placé EmbeddingGemma 2 sous la licence Apache 2.0, ce qui autorise une utilisation commerciale, la modification et l'intégration dans des produits propriétaires sans redevance.
Où télécharger les poids d'EmbeddingGemma 2 ?
Les poids originaux du modèle (google/embeddinggemma-2) sont téléchargeables gratuitement sur les plateformes Hugging Face et Kaggle.